배경
동네생활의 헤더와 하단 탭(바텀탭)은 동네생활 코드에 들어 있지 않다. 캐시워크의 여러 웹 서비스가 같은 헤더와 바텀탭을 쓰기 때문에, 별도 프로젝트에서 HTML 조각(프래그먼트)으로 빌드해 CDN에 올려두고 각 서비스가 가져다 쓴다. 이 구조를 MF(Module Federation)라고 부른다. 동네생활은 SSR 서버가 요청을 받을 때마다 이 프래그먼트를 받아서 페이지에 끼워 넣는 구조이다.
동네생활 페이지 속도를 살펴보다가 이상한 점이 보였다. 같은 서버에 있는 API 라우트(/api/healthcheck)는 173ms에 응답하는데, 페이지는 그보다 417~519ms가 더 걸렸다. 렌더링할 내용이 거의 없는 /404조차 692ms였다. 페이지마다 공통으로 거치는 _app에서 시간을 쓰고 있다는 뜻이었다.
헤더를 불러오는 데만 네 번의 요청이 오갔다
_app을 열어보니 프래그먼트를 불러오는 코드가 있었다.
try {
  remoteHeader = await fetchRemoteFragment('AppHeader', {
    currentPath,
    logoHref: '/local/community',
    logoImageUrl,
  });
} catch (e) {
  console.error('[RemoteFragment] AppHeader 로드 실패:', e);
}

try {
  remoteBottomNav = await fetchRemoteFragment('BottomNav', { currentPath });
} catch (e) {
  console.error('[RemoteFragment] BottomNav 로드 실패:', e);
}
헤더를 다 받은 뒤에야 바텀탭을 받는다. 그리고 fetchRemoteFragment 안에서도 두 번에 나눠 요청한다. 먼저 manifest.json(어떤 프래그먼트가 어떤 파일명으로 올라가 있는지 적힌 목록)을 받고, 거기서 파일명을 찾아 HTML을 받는다. 그래서 요청 한 번에 manifest.json → AppHeader.html → manifest.json → BottomNav.html 네 번의 요청이 차례로 오갔다. 그중 manifest.json은 같은 파일을 두 번 받는 것이었다.
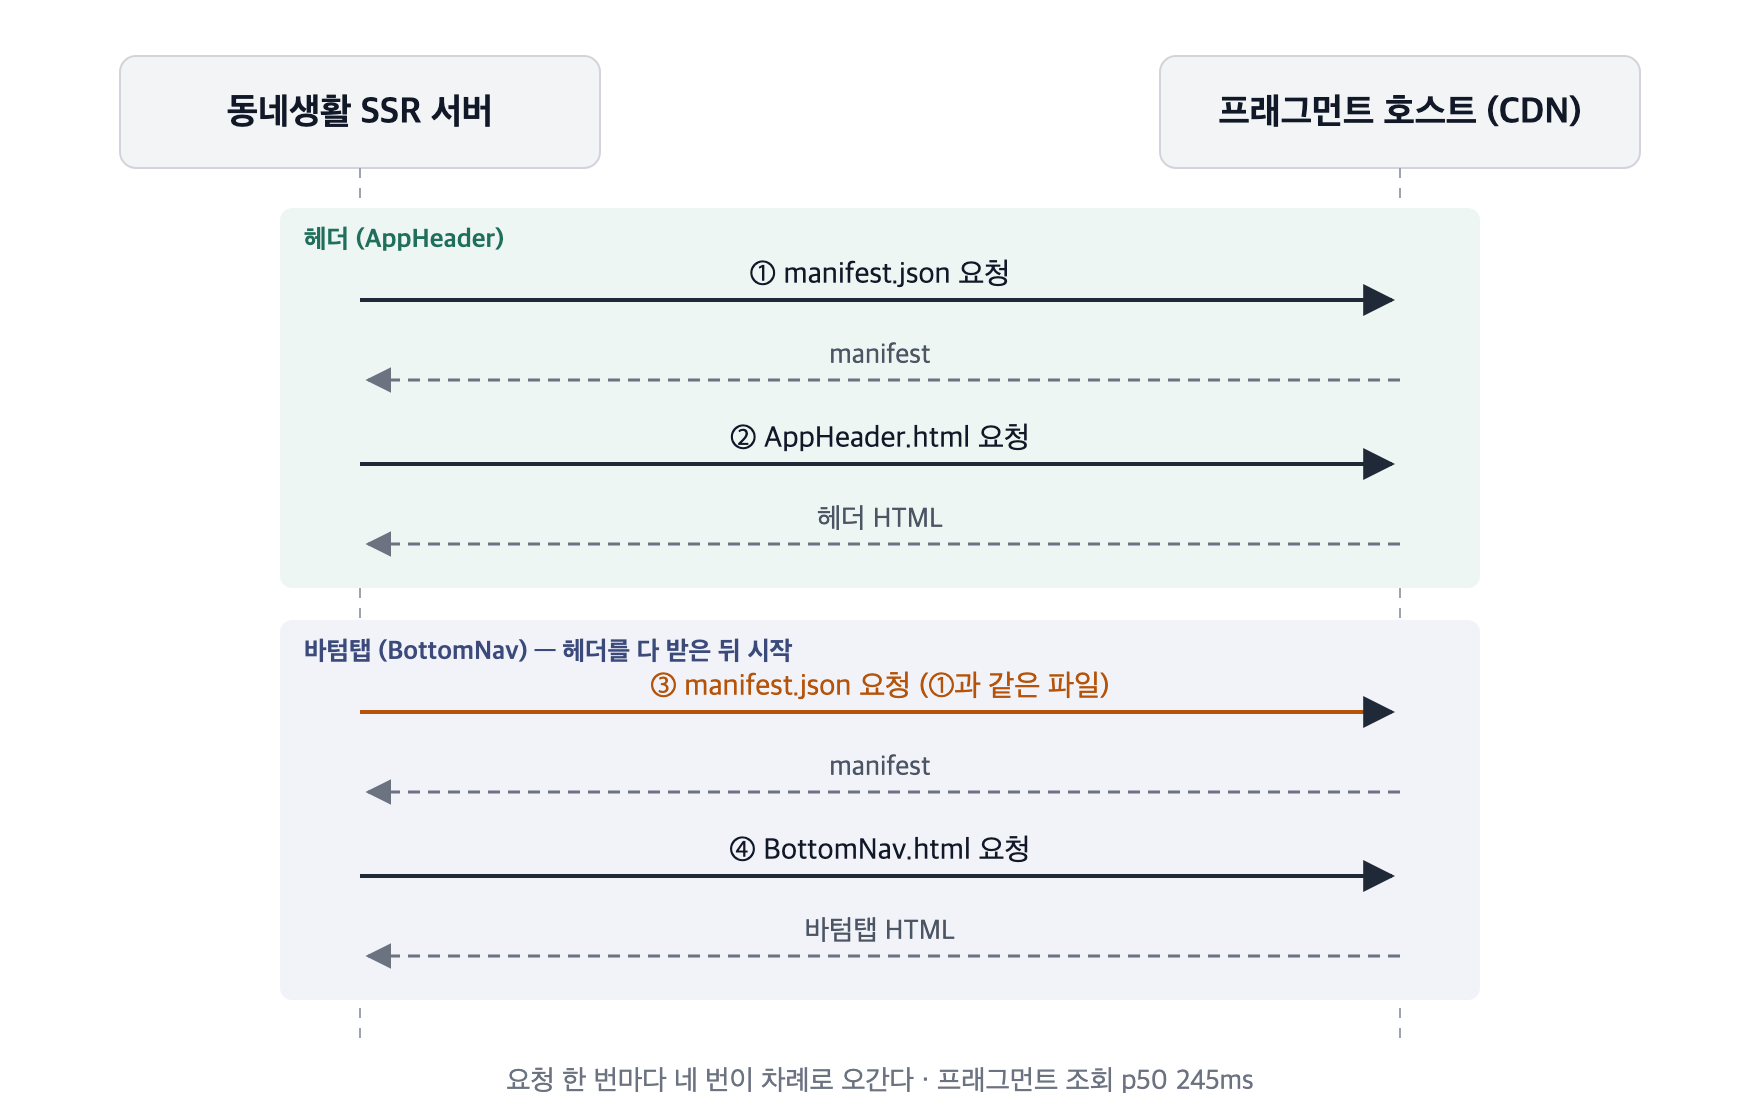
게다가 manifest.json은 CDN 응답이 cache-control: no-cache, x-cache: Miss from cloudfront였다. 매 요청마다 원본 서버까지 다녀온다는 뜻이다. 로컬에서 이 네 번의 요청에 걸리는 시간을 재보니 245ms(p50)였다. 페이지가 뜰 때마다 헤더를 받느라 0.25초를 쓰고 있었던 것이다.
병렬로 불러오기
가장 먼저 떠오른 건 순서를 바꾸는 것이었다. 헤더와 바텀탭은 서로를 기다릴 이유가 없다. 둘 다 같은 manifest.json을 쓰니 manifest는 한 번만 받아서 나눠 쓰고, HTML 두 개는 Promise.allSettled로 동시에 받도록 바꿨다. 한쪽이 실패해도 다른 쪽은 그대로 그리기 위해 Promise.all이 아니라 allSettled를 썼다.
const manifest = fetchRemoteFragmentManifest();

const [headerResult, bottomNavResult] = await Promise.allSettled([
  fetchRemoteFragment('AppHeader', {
    manifest,
    currentPath,
    logoHref,
    logoImageUrl,
  }),
  fetchRemoteFragment('BottomNav', {
    manifest,
    currentPath,
  }),
]);
이렇게 하면 네 번의 요청이 manifest 한 번, HTML 두 개 동시 요청의 두 단계로 줄어든다. 조회 시간은 245ms에서 141ms로 104ms 줄었다.
캐싱
캐싱까지 하면 어떨까?
병렬로 바꿔도 요청마다 두 번의 왕복은 그대로 남는다. 그런데 헤더와 바텀탭은 요청마다 달라지는 내용이 아니다. 프래그먼트를 새로 배포하기 전까지는 모든 사용자가 같은 HTML을 받는다. 그렇다면 한 번 받은 결과를 서버에 들고 있다가 다시 쓰면, 이 왕복도 없앨 수 있겠다고 생각했다.
사실 코드에는 이미 캐싱 옵션이 붙어 있었다.
const manifestRes = await fetch(`${MANIFEST_URL}/manifest.json`, {
  next: { revalidate: 60 },
});
60초 동안 결과를 재사용하라는 뜻이다. 그런데 이 옵션은 Node의 fetch 기능이 아니라 Next.js가 fetch를 감싸서 만든 기능이고, App Router에서 렌더링할 때만 동작한다. 동네생활은 Pages Router였고, 이 코드는 _app의 getInitialProps 안에 있었다. 옵션은 붙어 있었지만 아무 일도 하지 않고 있었다. 캐싱이 걸려 있는 줄 알았던 요청이 전부 매번 새로 나가고 있었던 것이다.
캐싱 방법에 대한 고민
캐싱을 하려면 방법을 정해야 했다. 검토한 방법은 네 가지다.
- App Router로 전체 전환 :
revalidate가 동작하는 환경으로 옮긴다._app.tsx를layout.tsx로 바꾸는 것부터 모든 페이지를 옮겨야 하고, Next.js 버전도 올려야 한다. - App Router로 일부 전환 : 프래그먼트 조회만 App Router의 라우트 핸들러(
app/api/fragments/route.ts)로 빼고, 거기서revalidate를 쓴다. 현재 버전(13.3.1)에서는 실험 기능 플래그를 켜거나 13.4 이상으로 올려야 하고, 요청마다 자기 서버로 HTTP 요청을 한 번 더 보내게 된다. lru-cache라이브러리 : Node 서버 캐시에서 사실상 표준으로 쓰이는 라이브러리로, Next.js 내부에서도 쓴다. 필요한 기능은 다 있지만 새 의존성이 생긴다.- 직접 구현 : 서버 메모리에
Map하나를 두고 응답을 저장한다.
나는 4번을 제안했다. App Router 전환은 캐싱 하나를 위해 치르기에는 비용이 너무 컸고, 라이브러리도 이 한 곳에서만 쓰기에는 과하다고 생각했다. 파트장님도 어차피 동네생활을 나중에 Astro로 옮겨야 해서, App Router로 전환하는 건 좋지 않다는 의견이었다. 그래서 지금 구조를 유지하면서 캐시를 직접 구현하되, 코드를 모듈로 분리해 읽기 쉽게 만드는 쪽으로 정했다.
가장 단순한 캐시는 URL을 키로 응답을 저장해 두고, 있으면 그걸 돌려주는 것이다. 하지만 이렇게만 하면 두 가지 문제가 생긴다.
첫째, 캐시가 만료되는 순간 그때 들어온 요청은 다시 네트워크를 기다려야 한다. 그래서 만료된 뒤에도 일단 저장된 값을 바로 돌려주고, 새 값은 뒤에서 받아오게 했다(SWR, stale-while-revalidate). 갱신에 실패하면 이전 값을 그대로 쓴다. 프래그먼트 서버가 잠깐 죽어도 헤더가 사라지지 않는다.
둘째, 캐시가 비어 있을 때 요청이 동시에 여러 개 들어오면 같은 URL로 요청이 여러 번 나간다. 그래서 진행 중인 요청을 Map에 따로 두고, 같은 URL의 요청이 오면 새로 보내지 않고 그 요청이 끝나기를 같이 기다리게 했다(single-flight).
export const cachedFetch = async (
  url: string,
  ttlMs = 60 * 1000
): Promise<string> => {
  const cachedBodyEntry = BODY_CACHE.get(url);

  if (cachedBodyEntry && Date.now() < cachedBodyEntry.refreshAt) {
    return cachedBodyEntry.body;
  }

  let inFlightRequest = IN_FLIGHT_REQUESTS.get(url);

  if (!inFlightRequest) {
    inFlightRequest = refreshBody(url, ttlMs);
    IN_FLIGHT_REQUESTS.set(url, inFlightRequest);
  }

  if (cachedBodyEntry) {
    return cachedBodyEntry.body;
  }

  return await inFlightRequest;
};
manifest는 자주 바뀌는 파일이 아니어서 10분마다 갱신하도록 했다. HTML은 파일명에 내용의 해시가 들어 있다. 파일명이 같으면 내용도 같으니 만료 없이 저장했다.
캐싱이 잘 되었을까?
캐시가 실제로 맞고 있는지는 서버 안을 들여다봐야 알 수 있다. 페이지 응답 시간에는 네트워크와 렌더링 시간이 다 섞여 있기 때문이다. 그래서 _app에서 프래그먼트 조회에 걸린 시간을 재서 Server-Timing 헤더에 실어 보내도록 했다. Server-Timing은 서버가 구간별로 걸린 시간을 응답 헤더로 알려주는 표준 헤더로, 브라우저 개발자 도구의 Network → Timing 탭에 막대로 그려진다. 별도 도구 없이 서버 안의 시간을 볼 수 있다.
// 구간별 소요 시간을 브라우저 DevTools Network → Timing에 그대로 노출한다
if (ctx.res && !ctx.res.headersSent && !ctx.res.writableEnded) {
  ctx.res.setHeader(
    'Server-Timing',
    `fragments;dur=${remoteFragmentDurationMs}, pageProps;dur=${pagePropsDurationMs}`
  );
}
테섭에 배포하고 세 경로에 30번씩 요청해 보니, 90번 모두 캐시에서 가져왔다. 서버 안에서 잰 프래그먼트 조회 시간은 1ms 안팎이었다.
캐싱 말고 같이 챙긴 것들
_app을 손보면서 두 가지를 더 고쳤다.
먼저 웹뷰 요청이다. 앱 안의 웹뷰에서는 이 헤더와 바텀탭을 화면에 그리지 않는다. 그런데 요청은 웹과 똑같이 네 번씩 보내고, 받은 결과는 그대로 버리고 있었다. 그래서 웹뷰 요청이면 조회 자체를 건너뛰게 했다. 웹뷰 쿠키를 넣고 요청해 보면 Server-Timing이 fragments;desc=skipped;dur=0으로 찍힌다.
다음은 번들 크기다. fetchRemoteFragment는 HTML이 변조되지 않았는지 확인하려고 Node의 crypto 모듈을 쓴다. 그런데 _app이 이 파일을 맨 위에서 import하고 있어서, 서버에서만 쓰는 crypto가 클라이언트 번들에도 들어갔다. 브라우저에는 crypto가 없으니 webpack이 대신 폴리필(crypto-browserify)을 넣고 있었다. import를 서버 요청 안에서만 불러오는 동적 import로 바꾸자, _app 청크가 366kB에서 229kB로, 첫 로드 때 받는 JS가 445kB에서 308kB로 줄었다.
속도도 빨라졌을까?
상용에 배포한 뒤 실제 사용자 브라우저에서 수집한 지표(Grafana Faro)로 배포 전날과 같은 시간대(11시~13시)를 비교했다. 사용자가 첫 바이트를 받기까지 걸린 시간(TTFB)의 중앙값이 1,178ms에서 508ms로 57% 줄었다. 원래 느리게 받던 상위 5% 사용자 기준(p95)으로는 2,483ms에서 1,354ms로 45% 줄었다.
줄어든 폭이 앞에서 잰 245ms보다 큰 것은, 245ms가 로컬에서 CDN으로 직접 요청해 잰 값이기 때문이다. 상용 서버 안에서는 같은 네 번의 요청이 더 오래 걸리고 있었다. 하루 사이 _app을 거치지 않는 healthcheck는 41ms 줄었는데, _app을 거치는 페이지는 500ms 안팎이 줄었다.
다른 서비스에도 적용하기
같은 프래그먼트를 쓰는 서비스는 동네생활만이 아니었다. 팀에서도 MF를 쓰는 다른 프로젝트들을 같이 점검해 보자는 이야기가 나왔고, 동네산책 통합 웹과 캐시워크 통합 홈페이지에 같은 캐시를 옮겼다. 두 곳은 Astro로 되어 있어서 cachedFetch를 각 레포의 컨벤션에 맞게 옮기고, manifest와 HTML 조회를 이 함수로 바꿨다.
동네산책은 레이아웃이 헤더를 본문 위에, 바텀탭을 본문 아래에 따로 그려야 해서 두 요청을 하나로 묶을 수 없었다. 대신 첫 번째 호출이 받아둔 manifest를 두 번째 호출이 캐시에서 꺼내 쓰니, 중복 조회는 그것만으로 사라졌다. 여기서도 Server-Timing으로 확인하려 했는데, CDN과 nginx를 거치면서 이 헤더가 지워졌다. 그래서 잰 값을 HTML 주석으로 내보내 확인했다. 프래그먼트 조회 시간은 585ms에서 1.2ms가 됐다.
통합 홈페이지는 실사용자 지표로 효과가 가장 또렷하게 보였다. TTFB 중앙값이 386ms에서 114ms로, 첫 화면이 그려지는 시점(FCP)이 564ms에서 176ms로, 가장 큰 요소가 그려지는 시점(LCP)이 640ms에서 164ms로 줄었다. 세 지표 모두 70% 안팎이다.
예시 코드도 함께 고치기
서비스 세 곳을 고쳐도 끝이 아니었다. MF 레포에는 프레임워크별로 프래그먼트를 가져다 쓰는 예시 코드가 있고, 새 프로젝트는 이 코드를 보고 그대로 붙인다. 예시가 그대로면 직렬 호출과 캐시 없는 조회가 다음 프로젝트로 다시 퍼지게 된다.
Next.js 예시는 라우터마다 다르게 했다. Pages Router 예시에는 동네생활에 넣은 cachedFetch를 그대로 넣었고, App Router 예시는 revalidate가 제대로 동작하니 fetch 캐싱을 그대로 쓰게 했다. Astro 예시도 동네산책에 넣은 cachedFetch로 바꿨다. Host 가이드 문서도 이 기준에 맞춰 고쳤다.
예시 프로젝트 구조 개선
캐싱을 라우터별로 나누다 보니 예시 폴더 구조가 눈에 걸렸다. lib만 라우터별로 나뉘어 있고, 페이지 파일은 최상위에 그대로 있었다.
examples/host-nextjs/
├── app/page.tsx
├── pages/index.tsx
└── lib/
    ├── app-router/{fetchRemoteFragment.ts, fetchRemoteLayout.ts}
    └── pages-router/{cachedFetch.ts, fetchRemoteFragment.ts, fetchRemoteLayout.ts}
이 구조에서는 app/page.tsx가 lib/app-router/를 쓴다는 걸 폴더만 봐서는 알 수 없다. 파일을 열어 import를 확인해야 한다. 실제로 Pages Router 예시만 먼저 고쳤을 때, app/page.tsx가 이름이 바뀌기 전 경로를 계속 가리키고 있을 수 있었다.
그래서 라우터별 폴더를 최상위로 올렸다. 폴더 안에서는 app/, pages/처럼 실제 Next.js 프로젝트에 들어갈 경로를 그대로 뒀다.
examples/host-nextjs/
├── app-router/
│   ├── app/page.tsx
│   └── lib/{fetchRemoteFragment.ts, fetchRemoteLayout.ts}
└── pages-router/
    ├── pages/index.tsx
    └── lib/{cachedFetch.ts, fetchRemoteFragment.ts, fetchRemoteLayout.ts}
라우터 안에 페이지 파일을 바로 두는 방법(app-router/page.tsx)도 생각했다. 폴더 깊이는 한 단계 줄지만, 그러면 이 파일이 실제 프로젝트의 어디에 들어갈 코드인지 경로만으로 알 수 없다. 이제 어떤 라우터를 쓰는 프로젝트든 폴더 하나를 통째로 보면 된다.
맺으며
처음에 예상했던 것보다 큰 개선(TTFB 50~70% 향상)이 있었다. 이 작업을 하면서 가장 뿌듯한 순간은 상용 배포를 무사히 마치고, PM님과 팀원들에게 향상된 수치를 공유할 때였다. 박수 이모지와 함께 팀원들이 축하해줄 때 가장 기뻤다. 그리고 다음날 SEO 리포팅에서 개선된 객관적인 수치를 공유해줄 때 한 번 더 기뻤다.
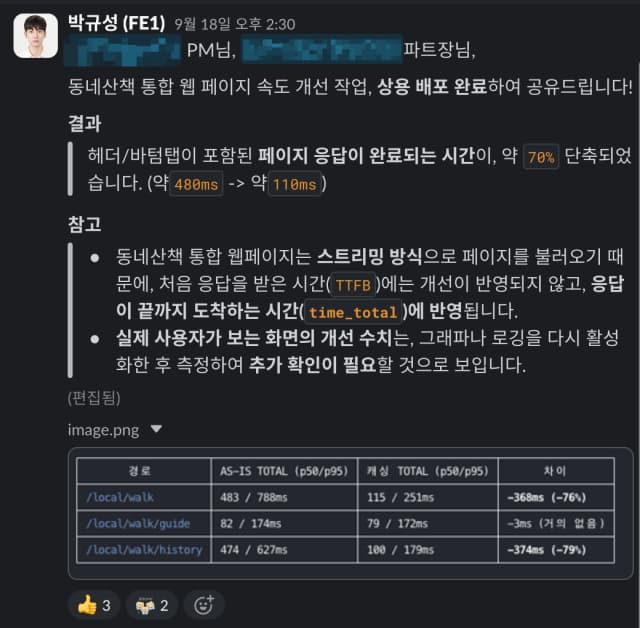
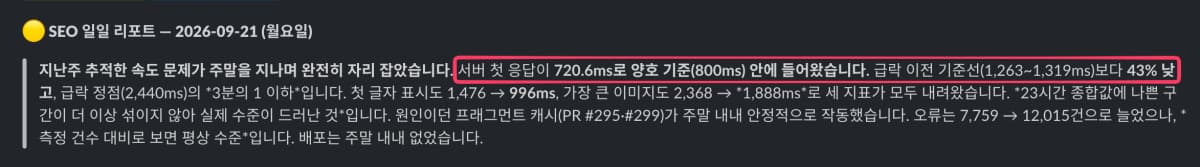
이번 작업에서 가장 오래 기억에 남는 건 revalidate 한 줄이다. 캐싱 옵션에 붙어 있었으니 당연히 캐시가 걸려 있을 것이라 처음에는 생각했다. 실제로 까봤을 때는 Pages Router의 getInitialProps에서 어떠한 캐싱도 일어나지 않고 있었던 것이다. 동작한다고 믿는 코드일수록 한 번 더 체크해봐야 한다는 걸 배울 수 있었다.
작업을 하면서 아쉬운 점도 있었다. 개선 작업을 테섭에 먼저 배포하고 나니, 개선 전 수치를 동일한 환경에서 다시 잴 수가 없었다. 개선 작업을 다시 되돌려 테섭에 반영해 측정하고, 다시 개선 작업을 반영하니 시간이 배로 걸렸다. 다음에는 개선 작업보다 반드시 측정 코드를 먼저 배포해서, 개선 전 수치를 측정하고 시작해야겠다는 생각을 했다.