들어가며
이전 글 : 웹 메모를 0.0.1부터 1.8.4까지 업데이트하며
나는 2년째 웹 메모 서비스를 혼자서 운영 중이다. 내 니즈에 의해 만들기 시작했고, 크롬 스토어에 출시를 했으며, 현재는 주간 활성 사용자 약 90명인 서비스로 성장시켰다. 서비스는 지난 2년간 지속적으로 운영하고 있으며 기능도 추가하고, 개선해오고 있다. 서비스는 끊임없이 운영 중이지만 나에게는 그 사이에 많은 변화가 있었다. 우아한테크코스라는 교육 프로그램을 수료하고, 현재는 넛지헬스케어에서 프론트엔드 개발자로 일을 하고 있다. 지속적으로 서비스를 운영하기 위해서는 여러가지 시스템과 장치들이 필요했다.
이번 글에서는 서비스를 지속적으로 운영하기 위해 추가했던, 혹은 시도했던 시스템에 대해서 소개하고자 한다.
배포 파이프라인
이전 글에서 프로젝트를 지속적으로 성장시키기 위한 첫 번째로 ‘안정적인 배포’를 꼽았다. 자동화된 배포 시스템이 있으면 코드를 작성하고 테스트하는 데에만 집중할 수 있기 때문이다. 지금도 그 생각은 동일하다. 다만 그 사이 웹 메모는 크롬 확장 프로그램을 넘어서 웹사이트와 앱 세 서비스로 확장했고, 배포를 자동화하는 것 자체만으로는 부족해졌다.
배포가 끝났는지 알 수 없다
머지를 하고 나면 GitHub Actions에 직접 들어가서 확인해야 했다. 웹이 배포됐는지, 웹은 배포됐는데 앱 빌드는 끝났는지, 빌드된 것이 어떤 작업인지는 Actions 화면을 열어보기 전에는 알 수 없었다. 또한, 확장 프로그램과 앱은 스토어에 올리기 전에 버전을 직접 올려서 커밋해야 했으며, 웹은 master에 머지하면 자동으로 배포가 되고 있어서 체계적인 시스템이 필요하다고 느꼈다.
개선된 배포 파이프라인
머지하는 브랜치에 따라 두 갈래로 나뉜다.
-
develop 머지 : 슬랙 채널에 ‘develop 머지’ 스레드가 만들어진다. 웹은 staging 환경에, 앱은 Android APK로 Firebase App Distribution에 자동으로 배포된다. 배포가 끝나면 동일한 스레드에 ‘테스트 서버 배포 완료’ 댓글이 달린다.
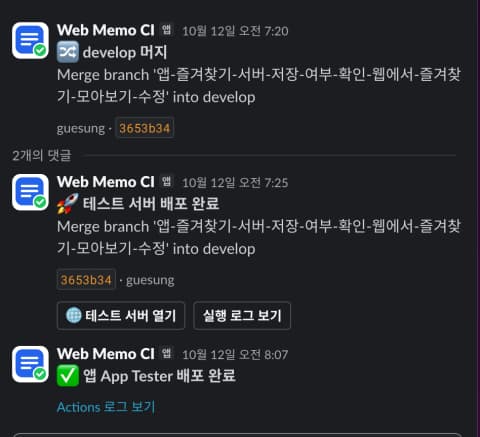
-
master 머지 : 슬랙 채널에 ‘master 머지’ 스레드가 만들어진다. 웹, 확장 프로그램, 앱은 각각 빌드만 한다. 타깃별로 빌드가 끝나면 ‘빌드 성공’의 댓글이 달리고, 성공 댓글에는
배포버튼이 붙는다. 버튼을 누르면 웹의 API 라우트가 요청을 받아 GitHub API로 release.yml을 실행한다. 웹은 프로덕션에, 확장은 크롬 웹 스토어에, 앱은 Play 내부 스토어로 제출된다.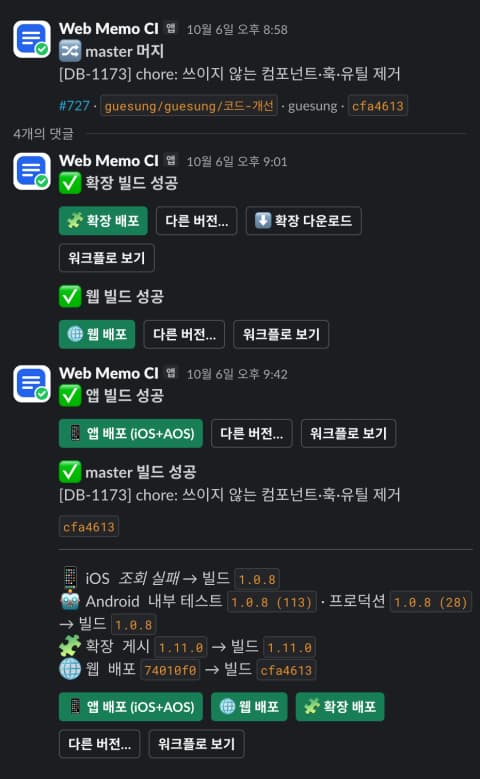
이제 웹, 확장 프로그램, 앱의 빌드와 배포는 모두 이 슬랙 스레드 하나로 관리를 할 수 있다. 어떤 커밋에서 빌드를 시작했고, 빌드가 끝났고, 출시를 할지 모두 결정하고 흐름을 관리할 수 있다. 또한 무엇보다도, 배포는 실사용자에게 영향을 미치는 것이기에 완전 자동화하는 것이 아닌, 내가 직접 결정하기 위함이 있었다.
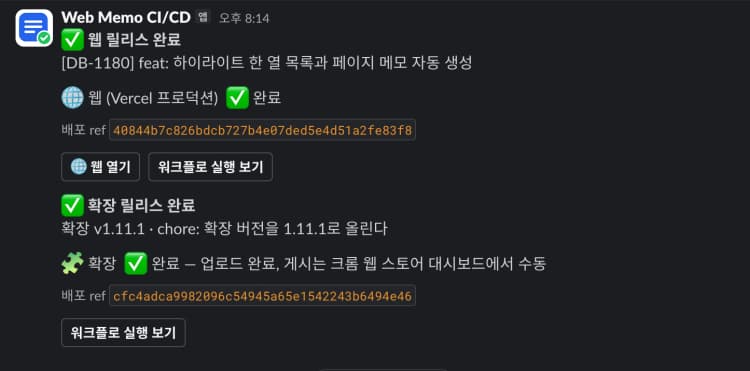
특히 여러 작업을 병행해서 진행할 때 진가를 발휘한다. 각 작업 단위로 ‘develop 머지’ 스레드가 생성이 되고, 내가 테스트를 원하는 스레드에 댓글이 달리면, 테섭에서 테스트를 해보면 되는 것이다.
에러 모니터링
대부분의 사용자는 서비스를 이용하다가 에러가 발생하면 이탈한다. 그 서비스의 큰 충성 고객이 아니라면 말이다. 그만큼 서비스에서 에러가 발생하지 않는 것은 서비스에 대한 신뢰로 직결된다고 할 수 있다. 그래서 에러가 발생하면, 개발자에게 이 에러 발생 사실을 즉시 알려 조치를 할 수 있도록 하는 것이 중요하다.
에러 발생 시 알림 흐름
웹 메모에서 에러가 발생하면 다음 순서로 슬랙에 알림이 온다.
- 확장 프로그램이나 웹에서 에러가 발생한다.
- 공통 리포터가 에러에
기능/동작/단계주소를 붙여 Sentry로 보낸다. - Sentry가 이슈를 만든다.
- Sentry의 Internal Integration이 웹의
/api/sentry-webhook으로 웹훅을 보낸다. - 웹훅 라우트가 서명을 검증하고, 슬랙 채널에 메시지를 보낸다.
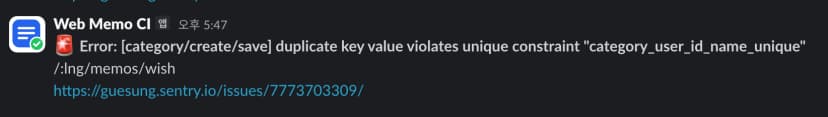
먼저 2단계의 리포터다. 확장은 @sentry/react, 웹은 @sentry/nextjs를 쓰기 때문에 공통 코드에서 SDK를 직접 import하지 않고, captureException을 인자로 주입받게 했다. 그리고 모든 보고에 기능·동작·단계 세 칸짜리 주소를 붙인다. 요약 기능의 fetch 단계에서 실패했다면 summary/generate/fetch, 메모를 만들다 DB에 넣는 단계에서 실패했다면 memo/create-memo/insert 같은 식이다. 이 주소는 태그와 fingerprint로 붙고, 이슈 제목 앞에도 붙는다.
// packages/shared/src/utils/errorReporter.ts
const original = error instanceof Error ? error : new Error(messageKey);
const labeled = new Error(
	`[${feature}/${operation}/${stage}] ${original.message}`,
	{ cause: original },
);

labeled.name = original.name;
labeled.stack = original.stack;
원본 에러를 직접 고치지 않고 새 에러로 감싼 이유는, 호출하는 쪽에서 Sentry 보고 직후에 error.message를 사용자 응답에 그대로 사용하기 때문이다. 대신 원본은 cause로 남기고 스택도 물려줘서, Sentry가 리포터 내부가 아니라 실제로 에러를 던진 위치를 가리키게 했다.
다음은 4~5단계의 웹훅 라우트다.
// apps/web/src/app/api/sentry-webhook/route.ts
export async function POST(request: Request) {
	const payload = await readVerifiedSentryWebhook(request);

	if (!payload) {
		return new NextResponse("invalid signature", { status: 401 });
	}

	if (!payload.data?.issue) {
		return NextResponse.json({ ok: true });
	}

	// 새로 생성된 이슈와, 한 번 resolve·ignore한 뒤 재발한 이슈만 알립니다.
	const isNotableAction =
		payload.action === "created" || payload.action === "unresolved";

	if (!isNotableAction) {
		return NextResponse.json({ ok: true });
	}

	try {
		await postSlackMessage({
			channel: getSentryAlertSlackChannel(),
			text: formatSentryAlertText(payload),
		});
	} catch (error) {
		console.error("Sentry 알림을 Slack으로 릴레이하는 데 실패했습니다:", error);
	}

	return NextResponse.json({ ok: true });
}
sentry-hook-signature 헤더를 HMAC-SHA256으로 검증하고, 서명이 맞지 않으면 401로 돌려보낸다. 슬랙으로 보내는 건 새 이슈가 생겼을 때(created)와 해결 처리한 이슈가 다시 발생했을 때(unresolved) 두 가지뿐이다. 이슈의 상태가 바뀔 때마다 알림을 보내면 슬랙이 금방 알림으로 가득 차기 때문에 이와 같이 구현했다.
유료 슬랙 연동 대신 웹훅을 쓴 이유
Sentry에서 슬랙으로 알림을 보내는 공식 연동은 유료 플랜에서만 쓸 수 있다. 그래서 무료로 쓸 수 있는 Internal Integration을 만들어 웹훅을 받고, 이미 배포 알림에 쓰고 있던 슬랙 봇으로 대신 보내는 방식으로 우회했다.
보고 코드는 있는데 이슈가 0건
리포터를 붙이고 나서 일부러 요약을 실패시켜봤다. DevTools로 요약 요청을 막았는데, 이슈가 하나도 생기지 않았다. Sentry는 분명히 초기화되어 있었다. 오류도, 경고도 없었다.
원인은 두 가지였다. 먼저 보내는 쪽. 확장의 initSentry()는 @sentry/react 9.47.1로 초기화하는데, 정작 captureException을 부르는 패키지들은 ^8.30.0을 쓰고 있어서 8.55.0으로 설치되어 있었다. Sentry는 클라이언트를 SDK 버전별로 보관한다. 그래서 v8의 captureException은 v9로 만든 클라이언트를 찾지 못했고, 이벤트는 오류 없이 버려졌다.
세 패키지의 버전을 ^9.47.1로 맞췄는데도 이슈는 생기지 않았다. 이번에는 받는 쪽의 문제였다. Sentry 프로젝트의 인바운드 필터 중 ‘browser extensions’가 chrome-extension://에서 난 오류를 서버에서 버리고 있었다. 지난 30일 동안 들어온 오류 106건 중 86건이 이 필터에 걸려 사라졌다. 이 필터는 다른 확장 프로그램이 일으킨 노이즈를 거르려는 것인데, 우리 프로젝트는 애초에 우리 확장 페이지의 오류만 보내니 거를 이유가 없었다. 필터를 끄고 나서야 [summary/generate/general] Failed to fetch 이슈가 생기고 슬랙 알림이 도착했다.
앞서 웹훅을 테스트할 때는 잘 동작했었다. 돌아보니 그때 curl로 만든 테스트 이벤트의 프레임이 app:///로 되어 있어서, 우연히 필터를 피해 갔던 것이다. 그리고 두 번째 원인은 첫 번째를 고친 뒤에야 보였다.
웹에서도 비슷한 일이 있었다. 지난 14일 동안 웹 프로젝트에 쌓인 이슈 3건이 모두 서버 에러였고, 브라우저에서 난 에러는 한 건도 없었다. 웹을 최근에 Next.js 14 Webpack에서 Next.js 16 Turbopack으로 마이그레이션을 한 이후였다. Turbopack은 sentry.client.config.js를 주입하지 않는다. 프로덕션 클라이언트 청크 29개 중 DSN이 들어간 청크가 0개인 것을 통해 알 수 있었다. 설정을 instrumentation-client.ts로 옮기고 나서야 브라우저 에러가 다시 전송되기 시작했다.
다시 깨지지 않게
고친 것들이 다시 깨지지 않게 하는 장치도 두었다. SDK 버전이 다시 갈라지지 않도록 syncpack으로 @sentry/react가 레포 전체에서 한 버전으로만 설치되게 묶고, CI에서 검사한다.
// .syncpackrc
{
	"label": "Sentry browser SDK must resolve to one version: captureException from a different copy than init is dropped silently (PR #528)",
	"dependencies": ["@sentry/react"],
	"preferVersion": "highestSemver"
}
특정 버전으로 고정하지 않고 ‘한 버전으로 맞춘다’만 강제했다. 막아야 하는 건 사본이 갈라지는 것이지, 버전이 올라가는 게 아니기 때문이다. 그리고 인바운드 필터나 웹훅처럼 코드가 아니라 Sentry 대시보드에만 있는 설정과, 지금까지 겪은 ‘보고가 조용히 사라지는 경로’는 docs/sentry.md 한 곳에 적어 두었다.
이렇게 만들어 둔 알림이 실제로 제 몫을 한 적도 있다. 하루는 [highlight/create/client_initialize_unexpected_error] 이슈가 1건 올라왔다. 제목에 붙은 주소만 보고 하이라이트를 만들 때 Supabase 클라이언트를 초기화하는 단계라는 걸 바로 알 수 있었고, 최초 발생 후 4시간 안에 원인을 찾았다. Supabase 클라이언트를 가져오다 난 오류를 종류와 상관없이 전부 unexpected_error로 뭉뚱그려 보고하고 있었던 것이다.
모니터링을 붙이는 것보다 어려웠던 건, 모니터링이 정말 동작하고 있는지를 확인하는 일이었다. 보고 코드가 있다고 보고가 되는 건 아니었다.
환경 변수 관리
웹 메모의 환경 변수는 다섯 군데에 흩어져 있다. GitHub Actions가 쓰는 GitHub Secrets, Next.js 서버가 쓰는 Vercel 환경 변수, Supabase Edge Function Secrets, 그리고 로컬 .env 파일과 환경별 공개 값을 담은 env 패키지까지.
어떤 환경 변수가 빠졌는지 알 수 없다
환경 변수 목록을 문서로 정리해 두긴 했었다. 그런데 GitHub, Vercel, Supabase에 실제로 등록된 목록과 문서를 대조해보니 세 곳 모두 문서와 달랐다. 운영 Vercel에는 Rate Limit에 쓰는 UPSTASH_REDIS_REST_*가 등록되어 있지 않아서, 그동안 OpenAI API 호출에 레이트 리밋이 꺼져 있었다. Supabase에는 SLACK_SIGNUP_WEBHOOK_URL도 빠져 있었다. 환경 변수가 늘어나고, 수정되고, 제거가 되면서 이 불일치가 점점 늘어나는 게 느껴지지만 시각적으로 보이지 않는다는 게 가장 큰 문제점이었다.
가장 치명적인 것은, 환경 변수는 빠져도 빌드와 배포는 통과한다는 점이다. 그 기능이 실행되는 순간에야 터지거나, Rate Limit처럼 아무 일 없다는 듯 기능이 조용히 꺼지는 것이다. 사람이 직접 문서를 손으로 맞추는 방식으로는 최신 상태를 유지할 수 없었다.
환경 변수 이름만 적는 목록 하나
그래서 .github/env-manifest.yml 한 파일에 모든 환경 변수의 이름을 적기로 했다. 값은 적지 않는다. 어디에 등록해야 하는지(stores), 어떤 파일이 읽는지(consumers), 빠지면 무슨 일이 생기는지(impact)만 적는다.
# .github/env-manifest.yml
- name: UPSTASH_REDIS_REST_URL
  kind: secret
  stores: [vercel]
  consumers: [apps/web/src/modules/ratelimit/rateLimit.ts]
  impact: "OpenAI API와 과거 메모 판정의 레이트 리밋이 조용히 꺼진다"
그리고 이 목록을 기준으로 두 가지를 검사한다.
-
PR마다: 코드와 워크플로가 읽는 환경 변수 이름이 목록에 모두 있는지, 목록에 적힌
consumers파일이 정말 그 이름을 읽는지 검사한다. 토큰이 필요 없기 때문에 의존성 설치 없이 6초 내에 끝난다. -
매일 아침 7시 30분: GitHub, Vercel, Supabase에 실제로 등록된 이름을 조회해서 목록과 비교한다. 빠진 값이 있으면 슬랙으로 알린다.
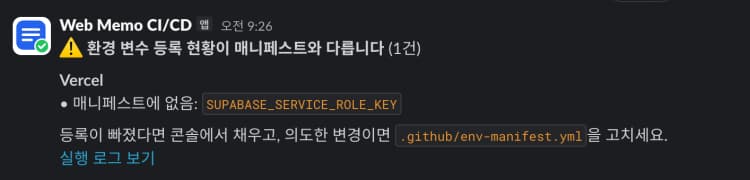
두 검사를 나눈 이유는 바뀌는 시점이 다르기 때문이다. 코드가 읽는 이름은 PR에서 바뀌기 때문에 PR마다 검사하고, 콘솔에 등록된 값은 PR과 상관없이 언제든지 바뀔 수 있기 때문에 주기적으로 검사를 한다.
알림이 없는 날은 정상일까?
매일 도는 검사를 만들며 고민한 건 알림이 오지 않은 날이었다. 알림이 없으면 모든 게 일치한 날일 수도 있지만, 검사 자체가 깨진 날일 수도 있다. 그래서 검사가 실패하면 차이 알림과 별개로 ‘감사 실패’ 알림을 보내게 했다. 이 실패 알림은 별도 스크립트 없이 워크플로 안에서 curl로 바로 보낸다. 실패 알림을 보내는 스크립트가 깨지면 같은 문제가 반복되기 때문이다.